Disentangling and Integrating Relational and Sensory Information in Transformer Architectures

Dual Attention augments Transformers with separate mechanisms for routing sensory and relational information.

arXiv Code Slides Poster Publisher

Abstract

Relational reasoning is a central component of generally intelligent systems, enabling robust and data-efficient inductive generalization. Recent empirical evidence shows that many existing neural architectures, including Transformers, struggle with tasks requiring relational reasoning. In this work, we distinguish between two types of information: sensory information about the properties of individual objects, and relational information about the relationships between objects. While neural attention provides a powerful mechanism for controlling the flow of sensory information between objects, the Transformer lacks an explicit computational mechanism for routing and processing relational information. To address this limitation, we propose an architectural extension of the Transformer framework that we call the Dual Attention Transformer (DAT), featuring two distinct attention mechanisms: sensory attention for directing the flow of sensory information, and a novel relational attention mechanism for directing the flow of relational information. We empirically evaluate DAT on a diverse set of tasks ranging from synthetic relational benchmarks to complex real-world tasks such as language modeling and visual processing. Our results demonstrate that integrating explicit relational computational mechanisms into the Transformer architecture leads to significant performance gains in terms of data efficiency and parameter efficiency.

(a)
(b)
(a)
(b)
Sensory and Relational Attention in the Dual Attention Transformer. Standard self-attention retrieves sensory information viv_i about the attributes of individual objects while relational attention retrieves relational information r(x,yi)r(x, y_i) about the relationship between the objects in the context and the receiver. Each relation is tagged with a symbol sis_i which acts as an abstract variable identifying the sender. In both cases, information is aggregated according to the attention scores αi\alpha_i, which are computed by a softmax over inner products of queries and keys.

Summary of Paper

The Transformer architecture can be understood as an instantiation of a broader computational paradigm implementing a form of neural message-passing that iterates between two operations: 1) information retrieval (self-attention), and 2) local processing (feedforward block). To process a sequence of objects x1,…,xnx_1, \ldots, x_n, this general neural message-passing paradigm has the form

xi←Aggregate(xi,{mj→i}j=1n)xi←Process(xi).\begin{align*} x_i &\gets \mathrm{Aggregate}(x_i, {\{m_{j \to i}\}}_{j=1}^n)\\ x_i &\gets \mathrm{Process}(x_i). \end{align*}

In the case of Transformers, the self-attention mechanism can be seen as sending messages from object jj to object ii that are encodings of the sender’s features, with the message from sender jj to receiver ii given by mj→i=ϕv(xj)m_{j \to i} = \phi_v(x_j). These messages are then aggregated according to some selection criterion based on the receiver’s features, typically given by the softmax attention scores.

We posit that there are essentially two types of information that need to be routed between objects under this general computational paradigm for sequence modeling: 1) sensory information describing the features and attributes of individual objects, and 2) relational information about the relationships between objects. The standard attention mechanism of Transformers naturally encodes the former, but does not explicitly encode the latter.

To capture routing relational information between objects, we propose a novel attention mechanism called relational attention. Under the message-passing lens, in relational attention, the message from object jj to object ii is mj→i=(r(xi,xj),sj)m_{j \to i} = (r(x_i, x_j), s_j): the relation between the sender and the receiver r(xi,xj)r(x_i, x_j) tagged with the identity of the sender sjs_j. The relation r(xi,xj)r(x_i, x_j) is represented by an inner product of feature maps, capturing a comparison of the two objects’ features under different filters. The identity of the sender is encoded by a vector sjs_j that we call object jj‘s “symbol”—it acts as a pointer to the object, enabling a relation-centric representation that is disentangled from sensory information.

RelationalAttention(x,(y1,…,yn))=∑i=1nαi(x,y)(r(x,yi)Wr+siWs),α(x,y)=Softmax([⟨ϕq,ℓattn(x),ϕk,ℓattn(yi)⟩]i=1n)∈Δn,r(x,y)=(⟨ϕq,ℓrel(x),ϕk,ℓrel(y)⟩)ℓ∈[dr]∈Rdr,(s1,…,sn)=SymbolRetriever(y;Slib).\begin{align*} \mathrm{RelationalAttention}(x, (y_1, \ldots, y_n)) &= \sum_{i=1}^{n} \alpha_i(x, \boldsymbol{y}) \left( r(x, y_i) W_r + s_i W_s \right), \\ \alpha(x, \boldsymbol{y}) &= \mathrm{Softmax}\big(\big[\langle \phi_{q, \ell}^{\mathrm{attn}}(x), \phi_{k, \ell}^{\mathrm{attn}}(y_i)\rangle\big]_{i=1}^{n}\big) \in \Delta^n,\\ r(x, y) &= \big(\langle \phi_{q, \ell}^{\mathrm{rel}}(x), \phi_{k, \ell}^{\mathrm{rel}}(y)\rangle\big)_{\ell \in [d_r]} \in \mathbb{R}^{d_r},\\ (s_1, \ldots, s_n) &= \mathrm{SymbolRetriever}(\boldsymbol{y}; S_{\mathrm{lib}}). \end{align*}

In relational attention, there exists two sets of query/key feature maps. ϕq,ℓattn,ϕk,ℓattn\phi_{q, \ell}^{\mathrm{attn}}, \phi_{k, \ell}^{\mathrm{attn}} are learned feature maps that control the selection criterion for which object(s) in the context to attend to (i.e., they are used to compute the attention scores α(x,y)∈Δn\alpha(x, \boldsymbol{y}) \in \Delta^n). ϕq,ℓattn,ϕk,ℓattn\phi_{q, \ell}^{\mathrm{attn}}, \phi_{k, \ell}^{\mathrm{attn}} are learned feature maps that represent the relationship between pairs of objects through inner product comparisons ⟨ϕq,ℓrel(x),ϕq,ℓrel(y)⟩\langle \phi_{q, \ell}^{\mathrm{rel}}(x), \phi_{q, \ell}^{\mathrm{rel}}(y)\rangle. The SymbolRetriever\mathrm{SymbolRetriever} learns a library of symbols SlibS_{\mathrm{lib}} and assigns a symbol to each object acting as a pointer or identifier. We consider three symbol assignment mechanisms that identify objects via: their absolute position in the sequence, their position relative to the receiver, or an equivalence class over their features.

To develop a model that supports both fundamental types of information (sensory and relational), we propose dual attention—a variant of multi-head attention composed of two types of attention heads. Standard self-attention heads handle routing sensory information between objects while relational attention heads handle routing relational information between objects. This gives rise to the Dual Attention Transformer, a versatile sequence model with both sensory and relational inductive biases.
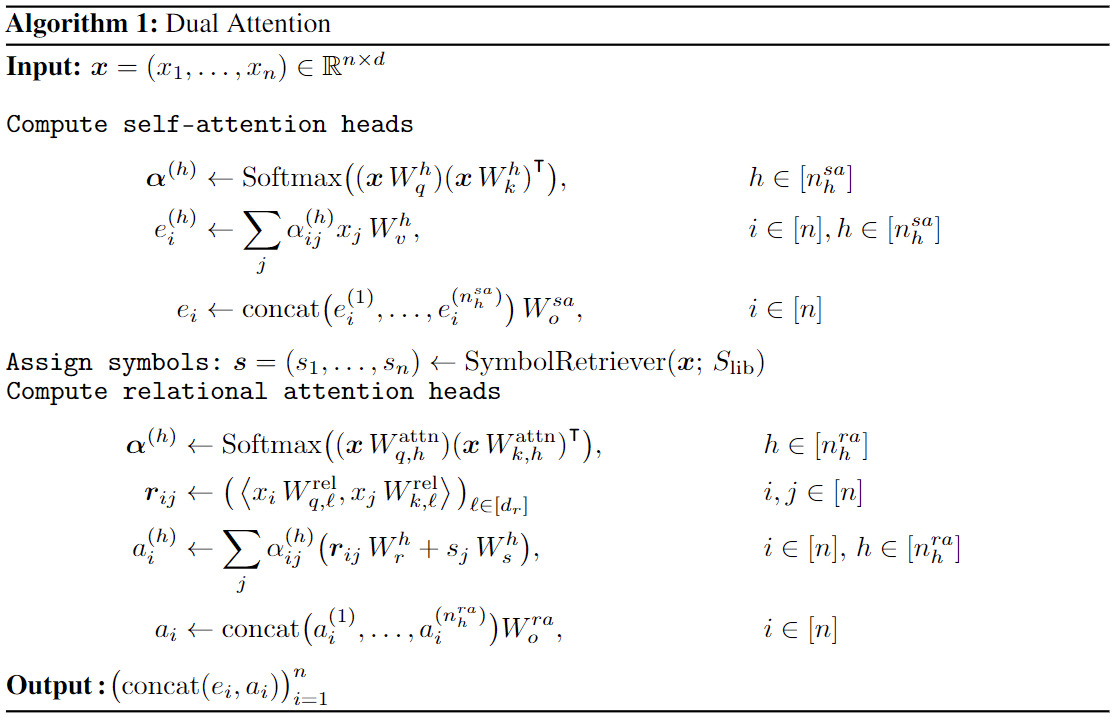
An algorithmic description of Dual Attention.

Highlights of Experiments

We empirically evaluate the Dual Attention Transformer (abbreviated, DAT) architecture on a range of tasks spanning different domains and modalities, with the goal of assessing the impact of relational computational mechanisms in complex real-world tasks.

Relational Reasoning

The first set of experiments evaluates the data-efficiency of DAT on visual relational reasoning tasks. We consider the “Relational Games” benchmark which is used for evaluating relational architectures. The learning curves depicted in the plot below show that DAT is significantly more data-efficient compared to a Transformer in learning relational tasks.

Relational Games: Data Efficiency in Relational Learning

0.50.60.70.80.91.00.50.60.70.80.91.05001k1.5k2k2.5k5001k1.5k2k2.5k5001k1.5k2k2.5k5k10k15k20k25k5001k1.5k2k2.5ksamebetweenoccursmatch patternxoccursTraining Set SizeAccuracyDAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 250 training examples accuracy 0.652 ± 0.008DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 500 training examples accuracy 0.744 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 750 training examples accuracy 0.815 ± 0.006DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,000 training examples accuracy 0.863 ± 0.002DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,250 training examples accuracy 0.882 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,500 training examples accuracy 0.898 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,750 training examples accuracy 0.906 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 2,000 training examples accuracy 0.914 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 2,250 training examples accuracy 0.929 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 2,500 training examples accuracy 0.926 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 250 training examples accuracy 0.639 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 500 training examples accuracy 0.744 ± 0.012DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 750 training examples accuracy 0.828 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,000 training examples accuracy 0.880 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,250 training examples accuracy 0.899 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,500 training examples accuracy 0.902 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,750 training examples accuracy 0.917 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 2,000 training examples accuracy 0.929 ± 0.001DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 2,250 training examples accuracy 0.937 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 2,500 training examples accuracy 0.940 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 250 training examples accuracy 0.671 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 500 training examples accuracy 0.750 ± 0.029Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 750 training examples accuracy 0.876 ± 0.013Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,000 training examples accuracy 0.898 ± 0.004Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,250 training examples accuracy 0.901 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,500 training examples accuracy 0.924 ± 0.004Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,750 training examples accuracy 0.931 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 2,000 training examples accuracy 0.938 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 2,250 training examples accuracy 0.946 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 2,500 training examples accuracy 0.946 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 250 training examples accuracy 0.614 ± 0.013DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 500 training examples accuracy 0.750 ± 0.012DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 750 training examples accuracy 0.836 ± 0.012DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,000 training examples accuracy 0.881 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,250 training examples accuracy 0.897 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,500 training examples accuracy 0.908 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,750 training examples accuracy 0.920 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 2,000 training examples accuracy 0.929 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 2,250 training examples accuracy 0.926 ± 0.002DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 2,500 training examples accuracy 0.931 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 250 training examples accuracy 0.640 ± 0.012DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 500 training examples accuracy 0.711 ± 0.015DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 750 training examples accuracy 0.816 ± 0.010DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,000 training examples accuracy 0.869 ± 0.010DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,250 training examples accuracy 0.898 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,500 training examples accuracy 0.911 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,750 training examples accuracy 0.923 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 2,000 training examples accuracy 0.929 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 2,250 training examples accuracy 0.930 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 2,500 training examples accuracy 0.938 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 250 training examples accuracy 0.596 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 500 training examples accuracy 0.618 ± 0.020Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 750 training examples accuracy 0.717 ± 0.015Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,000 training examples accuracy 0.774 ± 0.016Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,250 training examples accuracy 0.809 ± 0.018Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,500 training examples accuracy 0.845 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,750 training examples accuracy 0.870 ± 0.007Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 2,000 training examples accuracy 0.886 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 2,250 training examples accuracy 0.904 ± 0.007Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 2,500 training examples accuracy 0.911 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 250 training examples accuracy 0.632 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 500 training examples accuracy 0.787 ± 0.010DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 750 training examples accuracy 0.854 ± 0.006DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,000 training examples accuracy 0.886 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,250 training examples accuracy 0.899 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,500 training examples accuracy 0.910 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,750 training examples accuracy 0.920 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 2,000 training examples accuracy 0.916 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 2,250 training examples accuracy 0.930 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 2,500 training examples accuracy 0.931 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 250 training examples accuracy 0.619 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 500 training examples accuracy 0.775 ± 0.015DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 750 training examples accuracy 0.855 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,000 training examples accuracy 0.895 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,250 training examples accuracy 0.900 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,500 training examples accuracy 0.913 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,750 training examples accuracy 0.918 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 2,000 training examples accuracy 0.928 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 2,250 training examples accuracy 0.926 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 2,500 training examples accuracy 0.929 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 250 training examples accuracy 0.533 ± 0.004Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 500 training examples accuracy 0.525 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 750 training examples accuracy 0.616 ± 0.009Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,000 training examples accuracy 0.646 ± 0.011Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,250 training examples accuracy 0.698 ± 0.023Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,500 training examples accuracy 0.752 ± 0.043Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,750 training examples accuracy 0.763 ± 0.032Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 2,000 training examples accuracy 0.825 ± 0.037Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 2,250 training examples accuracy 0.884 ± 0.026Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 2,500 training examples accuracy 0.885 ± 0.039DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 5,000 training examples accuracy 0.528 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 7,500 training examples accuracy 0.682 ± 0.052DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 10,000 training examples accuracy 0.773 ± 0.048DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 12,500 training examples accuracy 0.792 ± 0.047DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 15,000 training examples accuracy 0.888 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 17,500 training examples accuracy 0.915 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 20,000 training examples accuracy 0.930 ± 0.008DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 22,500 training examples accuracy 0.918 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 25,000 training examples accuracy 0.928 ± 0.011DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 5,000 training examples accuracy 0.546 ± 0.029DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 7,500 training examples accuracy 0.606 ± 0.044DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 10,000 training examples accuracy 0.639 ± 0.044DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 12,500 training examples accuracy 0.742 ± 0.050DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 15,000 training examples accuracy 0.740 ± 0.044DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 17,500 training examples accuracy 0.762 ± 0.038DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 20,000 training examples accuracy 0.832 ± 0.039DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 22,500 training examples accuracy 0.901 ± 0.026DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 25,000 training examples accuracy 0.855 ± 0.032Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 5,000 training examples accuracy 0.511 ± 0.000Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 7,500 training examples accuracy 0.521 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 10,000 training examples accuracy 0.521 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 12,500 training examples accuracy 0.524 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 15,000 training examples accuracy 0.534 ± 0.001Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 17,500 training examples accuracy 0.538 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 20,000 training examples accuracy 0.564 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 22,500 training examples accuracy 0.565 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 25,000 training examples accuracy 0.565 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 250 training examples accuracy 0.520 ± 0.002DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 500 training examples accuracy 0.556 ± 0.006DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 750 training examples accuracy 0.620 ± 0.008DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,000 training examples accuracy 0.666 ± 0.014DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,250 training examples accuracy 0.754 ± 0.013DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,500 training examples accuracy 0.772 ± 0.017DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,750 training examples accuracy 0.823 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 2,000 training examples accuracy 0.860 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 2,250 training examples accuracy 0.873 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 2,500 training examples accuracy 0.886 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 250 training examples accuracy 0.522 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 500 training examples accuracy 0.543 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 750 training examples accuracy 0.585 ± 0.006DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,000 training examples accuracy 0.634 ± 0.008DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,250 training examples accuracy 0.716 ± 0.018DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,500 training examples accuracy 0.723 ± 0.017DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,750 training examples accuracy 0.827 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 2,000 training examples accuracy 0.852 ± 0.008DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 2,250 training examples accuracy 0.866 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 2,500 training examples accuracy 0.873 ± 0.009Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 250 training examples accuracy 0.508 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 500 training examples accuracy 0.504 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 750 training examples accuracy 0.527 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,000 training examples accuracy 0.546 ± 0.001Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,250 training examples accuracy 0.548 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,500 training examples accuracy 0.584 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,750 training examples accuracy 0.583 ± 0.013Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 2,000 training examples accuracy 0.598 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 2,250 training examples accuracy 0.679 ± 0.059Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 2,500 training examples accuracy 0.653 ± 0.010
0.50.60.70.80.91.00.50.60.70.80.91.00.50.60.70.80.91.05001.5k2.5k5001.5k2.5k5k15k25k5001.5k2.5k5001.5k2.5ksamexoccursmatch patternoccursbetweenTraining Set SizeAccuracyDAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$)DAT ($n_h^{sa}=1,\ n_h^{ra}=1$)Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$)DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 250 training examples accuracy 0.652 ± 0.008DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 500 training examples accuracy 0.744 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 750 training examples accuracy 0.815 ± 0.006DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,000 training examples accuracy 0.863 ± 0.002DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,250 training examples accuracy 0.882 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,500 training examples accuracy 0.898 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 1,750 training examples accuracy 0.906 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 2,000 training examples accuracy 0.914 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 2,250 training examples accuracy 0.929 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · same 2,500 training examples accuracy 0.926 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 250 training examples accuracy 0.639 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 500 training examples accuracy 0.744 ± 0.012DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 750 training examples accuracy 0.828 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,000 training examples accuracy 0.880 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,250 training examples accuracy 0.899 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,500 training examples accuracy 0.902 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 1,750 training examples accuracy 0.917 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 2,000 training examples accuracy 0.929 ± 0.001DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 2,250 training examples accuracy 0.937 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · same 2,500 training examples accuracy 0.940 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 250 training examples accuracy 0.671 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 500 training examples accuracy 0.750 ± 0.029Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 750 training examples accuracy 0.876 ± 0.013Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,000 training examples accuracy 0.898 ± 0.004Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,250 training examples accuracy 0.901 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,500 training examples accuracy 0.924 ± 0.004Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 1,750 training examples accuracy 0.931 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 2,000 training examples accuracy 0.938 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 2,250 training examples accuracy 0.946 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · same 2,500 training examples accuracy 0.946 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 250 training examples accuracy 0.520 ± 0.002DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 500 training examples accuracy 0.556 ± 0.006DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 750 training examples accuracy 0.620 ± 0.008DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,000 training examples accuracy 0.666 ± 0.014DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,250 training examples accuracy 0.754 ± 0.013DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,500 training examples accuracy 0.772 ± 0.017DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 1,750 training examples accuracy 0.823 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 2,000 training examples accuracy 0.860 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 2,250 training examples accuracy 0.873 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · xoccurs 2,500 training examples accuracy 0.886 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 250 training examples accuracy 0.522 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 500 training examples accuracy 0.543 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 750 training examples accuracy 0.585 ± 0.006DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,000 training examples accuracy 0.634 ± 0.008DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,250 training examples accuracy 0.716 ± 0.018DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,500 training examples accuracy 0.723 ± 0.017DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 1,750 training examples accuracy 0.827 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 2,000 training examples accuracy 0.852 ± 0.008DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 2,250 training examples accuracy 0.866 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · xoccurs 2,500 training examples accuracy 0.873 ± 0.009Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 250 training examples accuracy 0.508 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 500 training examples accuracy 0.504 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 750 training examples accuracy 0.527 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,000 training examples accuracy 0.546 ± 0.001Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,250 training examples accuracy 0.548 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,500 training examples accuracy 0.584 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 1,750 training examples accuracy 0.583 ± 0.013Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 2,000 training examples accuracy 0.598 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 2,250 training examples accuracy 0.679 ± 0.059Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · xoccurs 2,500 training examples accuracy 0.653 ± 0.010DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 5,000 training examples accuracy 0.528 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 7,500 training examples accuracy 0.682 ± 0.052DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 10,000 training examples accuracy 0.773 ± 0.048DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 12,500 training examples accuracy 0.792 ± 0.047DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 15,000 training examples accuracy 0.888 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 17,500 training examples accuracy 0.915 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 20,000 training examples accuracy 0.930 ± 0.008DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 22,500 training examples accuracy 0.918 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · match pattern 25,000 training examples accuracy 0.928 ± 0.011DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 5,000 training examples accuracy 0.546 ± 0.029DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 7,500 training examples accuracy 0.606 ± 0.044DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 10,000 training examples accuracy 0.639 ± 0.044DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 12,500 training examples accuracy 0.742 ± 0.050DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 15,000 training examples accuracy 0.740 ± 0.044DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 17,500 training examples accuracy 0.762 ± 0.038DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 20,000 training examples accuracy 0.832 ± 0.039DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 22,500 training examples accuracy 0.901 ± 0.026DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · match pattern 25,000 training examples accuracy 0.855 ± 0.032Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 5,000 training examples accuracy 0.511 ± 0.000Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 7,500 training examples accuracy 0.521 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 10,000 training examples accuracy 0.521 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 12,500 training examples accuracy 0.524 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 15,000 training examples accuracy 0.534 ± 0.001Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 17,500 training examples accuracy 0.538 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 20,000 training examples accuracy 0.564 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 22,500 training examples accuracy 0.565 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · match pattern 25,000 training examples accuracy 0.565 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 250 training examples accuracy 0.632 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 500 training examples accuracy 0.787 ± 0.010DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 750 training examples accuracy 0.854 ± 0.006DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,000 training examples accuracy 0.886 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,250 training examples accuracy 0.899 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,500 training examples accuracy 0.910 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 1,750 training examples accuracy 0.920 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 2,000 training examples accuracy 0.916 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 2,250 training examples accuracy 0.930 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · occurs 2,500 training examples accuracy 0.931 ± 0.003DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 250 training examples accuracy 0.619 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 500 training examples accuracy 0.775 ± 0.015DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 750 training examples accuracy 0.855 ± 0.007DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,000 training examples accuracy 0.895 ± 0.005DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,250 training examples accuracy 0.900 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,500 training examples accuracy 0.913 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 1,750 training examples accuracy 0.918 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 2,000 training examples accuracy 0.928 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 2,250 training examples accuracy 0.926 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · occurs 2,500 training examples accuracy 0.929 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 250 training examples accuracy 0.533 ± 0.004Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 500 training examples accuracy 0.525 ± 0.006Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 750 training examples accuracy 0.616 ± 0.009Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,000 training examples accuracy 0.646 ± 0.011Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,250 training examples accuracy 0.698 ± 0.023Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,500 training examples accuracy 0.752 ± 0.043Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 1,750 training examples accuracy 0.763 ± 0.032Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 2,000 training examples accuracy 0.825 ± 0.037Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 2,250 training examples accuracy 0.884 ± 0.026Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · occurs 2,500 training examples accuracy 0.885 ± 0.039DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 250 training examples accuracy 0.614 ± 0.013DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 500 training examples accuracy 0.750 ± 0.012DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 750 training examples accuracy 0.836 ± 0.012DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,000 training examples accuracy 0.881 ± 0.007DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,250 training examples accuracy 0.897 ± 0.004DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,500 training examples accuracy 0.908 ± 0.005DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 1,750 training examples accuracy 0.920 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 2,000 training examples accuracy 0.929 ± 0.003DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 2,250 training examples accuracy 0.926 ± 0.002DAT ($n_h^{sa}=0,\ n_h^{ra}=2$) · between 2,500 training examples accuracy 0.931 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 250 training examples accuracy 0.640 ± 0.012DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 500 training examples accuracy 0.711 ± 0.015DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 750 training examples accuracy 0.816 ± 0.010DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,000 training examples accuracy 0.869 ± 0.010DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,250 training examples accuracy 0.898 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,500 training examples accuracy 0.911 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 1,750 training examples accuracy 0.923 ± 0.004DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 2,000 training examples accuracy 0.929 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 2,250 training examples accuracy 0.930 ± 0.002DAT ($n_h^{sa}=1,\ n_h^{ra}=1$) · between 2,500 training examples accuracy 0.938 ± 0.002Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 250 training examples accuracy 0.596 ± 0.005Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 500 training examples accuracy 0.618 ± 0.020Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 750 training examples accuracy 0.717 ± 0.015Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,000 training examples accuracy 0.774 ± 0.016Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,250 training examples accuracy 0.809 ± 0.018Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,500 training examples accuracy 0.845 ± 0.010Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 1,750 training examples accuracy 0.870 ± 0.007Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 2,000 training examples accuracy 0.886 ± 0.003Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 2,250 training examples accuracy 0.904 ± 0.007Transformer ($n_h^{sa}=2,\ n_h^{ra}=0$) · between 2,500 training examples accuracy 0.911 ± 0.004

Mathematical Problem-Solving

Mathematical problem-solving is an interesting test for neural models because it requires more than statistical pattern recognition—it requires inferring laws, axioms, and symbol manipulation rules. To probe DAT’s abilities in symbolic reasoning in sequence-to-sequence tasks, we evaluate it on a mathematical problem-solving benchmark. We find that DAT outperforms standard Transformers consistently across model sizes.

Mathematical Problem Solving

0.60.70.80.840.860.880.9250.9500.9750.80.90.99850.99900.99951.0000750k1M1.25M1.75M750k1M1.25M1.75M750k1M1.25M1.75M750k1M1.25M1.75M750k1M1.25M1.75Malgebra__linear_1dpolynomials__addalgebra__sequence_next_termpolynomials__expandcalculus__differentiateParameter CountAccuracyTransformer · algebra__linear_1d 692k parameters accuracy 0.6248 ± 0.0114 (4 runs)Transformer · algebra__linear_1d 871k parameters accuracy 0.6399 ± 0.0147 (5 runs)Transformer · algebra__linear_1d 1.3M parameters accuracy 0.5698 ± 0.0230 (6 runs)Transformer · algebra__linear_1d 1.7M parameters accuracy 0.5325 ± 0.0107 (6 runs)DAT · algebra__linear_1d 832k parameters accuracy 0.6633 ± 0.0165 (7 runs)DAT · algebra__linear_1d 1.11M parameters accuracy 0.7622 ± 0.0354 (4 runs)DAT · algebra__linear_1d 1.46M parameters accuracy 0.7532 ± 0.0502 (4 runs)Transformer · polynomials__add 692k parameters accuracy 0.8327 ± 0.0005 (4 runs)Transformer · polynomials__add 871k parameters accuracy 0.8446 ± 0.0027 (5 runs)Transformer · polynomials__add 1.3M parameters accuracy 0.8643 ± 0.0027 (8 runs)Transformer · polynomials__add 1.7M parameters accuracy 0.8756 ± 0.0024 (8 runs)DAT · polynomials__add 832k parameters accuracy 0.8589 ± 0.0006 (7 runs)DAT · polynomials__add 1.11M parameters accuracy 0.8789 ± 0.0002 (5 runs)DAT · polynomials__add 1.46M parameters accuracy 0.8869 ± 0.0005 (4 runs)Transformer · algebra__sequence_next_term 692k parameters accuracy 0.9105 ± 0.0020 (4 runs)Transformer · algebra__sequence_next_term 871k parameters accuracy 0.9145 ± 0.0024 (5 runs)Transformer · algebra__sequence_next_term 1.3M parameters accuracy 0.9610 ± 0.0051 (8 runs)Transformer · algebra__sequence_next_term 1.7M parameters accuracy 0.9337 ± 0.0201 (8 runs)DAT · algebra__sequence_next_term 832k parameters accuracy 0.9212 ± 0.0044 (6 runs)DAT · algebra__sequence_next_term 1.11M parameters accuracy 0.9764 ± 0.0043 (5 runs)DAT · algebra__sequence_next_term 1.46M parameters accuracy 0.9877 ± 0.0028 (2 runs)Transformer · polynomials__expand 692k parameters accuracy 0.7403 ± 0.0070 (4 runs)Transformer · polynomials__expand 871k parameters accuracy 0.7407 ± 0.0061 (5 runs)Transformer · polynomials__expand 1.3M parameters accuracy 0.8095 ± 0.0118 (8 runs)Transformer · polynomials__expand 1.7M parameters accuracy 0.8921 ± 0.0051 (8 runs)DAT · polynomials__expand 832k parameters accuracy 0.7794 ± 0.0012 (7 runs)DAT · polynomials__expand 1.11M parameters accuracy 0.8691 ± 0.0096 (4 runs)DAT · polynomials__expand 1.46M parameters accuracy 0.9014 ± 0.0246 (2 runs)Transformer · calculus__differentiate 692k parameters accuracy 0.9989 ± 0.0003 (4 runs)Transformer · calculus__differentiate 871k parameters accuracy 0.9988 ± 0.0001 (5 runs)Transformer · calculus__differentiate 1.3M parameters accuracy 0.9991 ± 0.0002 (8 runs)Transformer · calculus__differentiate 1.7M parameters accuracy 0.9988 ± 0.0004 (8 runs)DAT · calculus__differentiate 832k parameters accuracy 0.9999 ± 0.0000 (8 runs)DAT · calculus__differentiate 1.11M parameters accuracy 1.0000 ± 0.0000 (3 runs)DAT · calculus__differentiate 1.46M parameters accuracy 1.0000 ± 0.0000 (4 runs)
0.60.70.80.99850.99900.99951.00000.80.90.9250.9500.9750.840.860.88750k1.25M1.75M750k1.25M1.75M750k1.25M1.75M750k1.25M1.75M750k1.25M1.75Malgebra__linear_1dcalculus__differentiatepolynomials__expandalgebra__sequence_next_termpolynomials__addParameter CountAccuracyTransformer · algebra__linear_1d 692k parameters accuracy 0.6248 ± 0.0114 (4 runs)Transformer · algebra__linear_1d 871k parameters accuracy 0.6399 ± 0.0147 (5 runs)Transformer · algebra__linear_1d 1.3M parameters accuracy 0.5698 ± 0.0230 (6 runs)Transformer · algebra__linear_1d 1.7M parameters accuracy 0.5325 ± 0.0107 (6 runs)DAT · algebra__linear_1d 832k parameters accuracy 0.6633 ± 0.0165 (7 runs)DAT · algebra__linear_1d 1.11M parameters accuracy 0.7622 ± 0.0354 (4 runs)DAT · algebra__linear_1d 1.46M parameters accuracy 0.7532 ± 0.0502 (4 runs)Transformer · calculus__differentiate 692k parameters accuracy 0.9989 ± 0.0003 (4 runs)Transformer · calculus__differentiate 871k parameters accuracy 0.9988 ± 0.0001 (5 runs)Transformer · calculus__differentiate 1.3M parameters accuracy 0.9991 ± 0.0002 (8 runs)Transformer · calculus__differentiate 1.7M parameters accuracy 0.9988 ± 0.0004 (8 runs)DAT · calculus__differentiate 832k parameters accuracy 0.9999 ± 0.0000 (8 runs)DAT · calculus__differentiate 1.11M parameters accuracy 1.0000 ± 0.0000 (3 runs)DAT · calculus__differentiate 1.46M parameters accuracy 1.0000 ± 0.0000 (4 runs)Transformer · polynomials__expand 692k parameters accuracy 0.7403 ± 0.0070 (4 runs)Transformer · polynomials__expand 871k parameters accuracy 0.7407 ± 0.0061 (5 runs)Transformer · polynomials__expand 1.3M parameters accuracy 0.8095 ± 0.0118 (8 runs)Transformer · polynomials__expand 1.7M parameters accuracy 0.8921 ± 0.0051 (8 runs)DAT · polynomials__expand 832k parameters accuracy 0.7794 ± 0.0012 (7 runs)DAT · polynomials__expand 1.11M parameters accuracy 0.8691 ± 0.0096 (4 runs)DAT · polynomials__expand 1.46M parameters accuracy 0.9014 ± 0.0246 (2 runs)Transformer · algebra__sequence_next_term 692k parameters accuracy 0.9105 ± 0.0020 (4 runs)Transformer · algebra__sequence_next_term 871k parameters accuracy 0.9145 ± 0.0024 (5 runs)Transformer · algebra__sequence_next_term 1.3M parameters accuracy 0.9610 ± 0.0051 (8 runs)Transformer · algebra__sequence_next_term 1.7M parameters accuracy 0.9337 ± 0.0201 (8 runs)DAT · algebra__sequence_next_term 832k parameters accuracy 0.9212 ± 0.0044 (6 runs)DAT · algebra__sequence_next_term 1.11M parameters accuracy 0.9764 ± 0.0043 (5 runs)DAT · algebra__sequence_next_term 1.46M parameters accuracy 0.9877 ± 0.0028 (2 runs)Transformer · polynomials__add 692k parameters accuracy 0.8327 ± 0.0005 (4 runs)Transformer · polynomials__add 871k parameters accuracy 0.8446 ± 0.0027 (5 runs)Transformer · polynomials__add 1.3M parameters accuracy 0.8643 ± 0.0027 (8 runs)Transformer · polynomials__add 1.7M parameters accuracy 0.8756 ± 0.0024 (8 runs)DAT · polynomials__add 832k parameters accuracy 0.8589 ± 0.0006 (7 runs)DAT · polynomials__add 1.11M parameters accuracy 0.8789 ± 0.0002 (5 runs)DAT · polynomials__add 1.46M parameters accuracy 0.8869 ± 0.0005 (4 runs)

Visual Processing

In this section, we explore how the relational computational mechanisms introduced into DAT—namely, relational attention—impact visual processing tasks. We evaluate a ViT-style DAT architecture (ViDAT), and compare it against a standard ViT on the CIFAR image recognition benchmarks. We find that the ViDAT architecture outperforms the standard ViT architecture across both datasets, suggesting that the relational computational mechanisms confer benefits in visual processing.

DatasetModelParameter Count# Layersdmodeld_{\mathrm{model}}nhsan_h^{sa}nhran_h^{ra}Accuracy
CIFAR-10ViT7.1M838412086.4 ± 0.1%
CIFAR-10ViDAT6.0M83846689.7 ± 0.1%
CIFAR-100ViT7.2M838412068.8 ± 0.2%
CIFAR-100ViDAT6.1M83846670.5 ± 0.1%

Language Modeling

Language understanding involves processing and organizing relational information, such as syntactic structures, semantic roles, and contextual dependencies, to extract meaning from words and their connections within sentences. We evaluate the impact of the relational computational mechanisms of DAT in language modeling, training models upto 1.3B parameters in size. We observe improvements in data efficiency and parameter efficiency compared to standard Transformers. By visualizing the internal relational representations of trained DAT language models, we find evidence that they encode human-interpretable semantic relations.

Language Modeling Scaling Laws

1B2B5B10BTokens350M750M1.3BParameter CountDAT · perplexity 30 343M parameters 1.05B tokensDAT · perplexity 30 734M parameters 786M tokensDAT · perplexity 30 1.27B parameters 786M tokensTransformer · perplexity 30 353M parameters 1.18B tokensTransformer · perplexity 30 757M parameters 918M tokensTransformer · perplexity 30 1.31B parameters 918M tokensDAT · perplexity 27 343M parameters 1.31B tokensDAT · perplexity 27 734M parameters 1.05B tokensDAT · perplexity 27 1.27B parameters 918M tokensTransformer · perplexity 27 353M parameters 1.57B tokensTransformer · perplexity 27 757M parameters 1.18B tokensTransformer · perplexity 27 1.31B parameters 1.05B tokensDAT · perplexity 24 343M parameters 1.84B tokensDAT · perplexity 24 734M parameters 1.44B tokensDAT · perplexity 24 1.27B parameters 1.18B tokensTransformer · perplexity 24 353M parameters 2.23B tokensTransformer · perplexity 24 757M parameters 1.57B tokensTransformer · perplexity 24 1.31B parameters 1.31B tokensDAT · perplexity 21 343M parameters 3.01B tokensDAT · perplexity 21 734M parameters 2.1B tokensDAT · perplexity 21 1.27B parameters 1.7B tokensTransformer · perplexity 21 353M parameters 3.67B tokensTransformer · perplexity 21 757M parameters 2.36B tokensTransformer · perplexity 21 1.31B parameters 1.97B tokensDAT · perplexity 18 343M parameters 5.77B tokensDAT · perplexity 18 734M parameters 3.8B tokensDAT · perplexity 18 1.27B parameters 3.01B tokensTransformer · perplexity 18 353M parameters 7.08B tokensTransformer · perplexity 18 757M parameters 4.19B tokensTransformer · perplexity 18 1.31B parameters 3.28B tokensDAT · perplexity 15 734M parameters 7.73B tokensDAT · perplexity 15 1.27B parameters 6.03B tokensTransformer · perplexity 15 757M parameters 8.78B tokensTransformer · perplexity 15 1.31B parameters 6.55B tokens302724211815Perplexity

Learn More

  • dual-attention Python Package. The dual-attention package published on the Python Package Index implements the Dual Attention Transformer model and its associated layers and modules. The package also includes utilities for visualizing internal representations of pretrained DAT language models as well as loading pretrained model checkpoints from Huggingface.
  • Documentation. The dual-attention documentation provides a user guide for the different components of the package.
  • Experiment Code. This is the github repository used throughout the development of the project. It includes the code used to run each set of experiments in the paper together with instructions for reproducing our experimental results.
Related
PaperThis page

Disentangling and Integrating Relational and Sensory Information in Transformer Architectures

transformersarchitecturesinductive biasesrelational reasoninggeneralizationlanguage models

Dual Attention augments Transformers with separate mechanisms for routing sensory and relational information.

Cite
@misc{altabaa2024disentanglingintegratingrelationalsensory,
      title={Disentangling and Integrating Relational and Sensory Information in Transformer Architectures},
      author={Awni Altabaa and John Lafferty},
      year={2024},
      eprint={2405.16727},
      archivePrefix={arXiv},
      primaryClass={cs.LG},
      url={https://arxiv.org/abs/2405.16727},
}